I costi unitari dell'intelligenza a consumo
Il prezzo dell’intelligenza a consumo non sta scendendo allo stesso modo per tutti. Le curve di OpenAI, Anthropic e Google raccontano strategie diverse di monetizzazione della frontiera, mentre il costo per token resta solo una misura parziale del costo reale di una soluzione AI.
Il prezzo dei token è diventato una delle misure più citate quando si parla del costo della Generative AI. È comodo, apparentemente oggettivo e facile da mettere in una tabella: dollari per milione di token in input, dollari per milione di token in output.
Il token è in realtà l’unità discreta in cui viene suddiviso il flusso di contenuti scambiato con il modello, non l’unità minima del valore del servizio offerto dal modello stesso. Due modelli con prezzi simili possono comportarsi in modo molto diverso; due modelli con prezzi molto differenti possono invece produrre costi comparabili sullo stesso workflow, se quello più capace richiede meno iterazioni, meno correzioni o meno orchestrazione (overo meno token scambiati con il modello).
Ciononostante è comunque interessante osservare come stanno evolvendo i listini, perché offrono lo spunto per riflettere sull’efficienza tecnologica e sulle strategie commerciali dei principali provider.
Ho quindi provato a confrontare l’evoluzione del prezzo dei modelli di frontiera di OpenAI, Anthropic e Google, concentrandomi sul costo dei token di output (quelli più direttamente associabili al concetto di produzione di contenuti/erogazione di un servizio).
Perché confrontare i costi dei token è difficile
Il primo problema è che non tutti i token sono uguali e il loro costo dipende da molteplici fattori.
Questo non soltanto perché i provider utilizzano tokenizer differenti per cui la stessa frase può essere codificata in modi diversi (e con un numero di token diverso), ma anche perché il pricing è diventato molto più articolato. Cache, batch, priority o flex processing, long context, data residency, grounding e tool specifici introducono tariffe differenti. Il list price input/output è quindi soltanto il primo livello della funzione di costo.
La finestra di contesto aggiunge un’ulteriore variabile: alcuni modelli applicano tariffe differenti oltre determinate soglie. Nei workload basati su grandi documenti, codebase o conversazioni persistenti, questa differenza può diventare significativa.
Ci sono poi molteplici altri fattori che determinano il reale costo progettuale della AI Generativa a partire dall’architettura dell’applicazione con retrieval, tool calling, contesto ripetuto, verifiche automatiche e soprattutto workflow agentici che moltiplicano chiamate e token consumati.
Per questo il prezzo per token non può essere utilizzato direttamente come misura del costo di un progetto. Può però essere un buon indicatore per osservare come i provider stanno prezzando l’accesso alla frontiera tecnologica.
La serie storica dei modelli frontier
Partiamo dall’approccio che ho utilizzato per ricostruire le curve di prezzo dei modelli di frontiera attraverso cui analizzare i trend, i tempi delle evoluzioni tecnologiche e le strategie commerciali dei principali provider.
Nella ricostruzione delle curve di prezzo, per ciascun provider ho considerato, in ciascun momento temporale, il modello general-purpose o di reasoning di massima capacità effettivamente disponibile attraverso una API commerciale, sulla base del posizionamento del vendor e delle prestazioni pubblicate.
Non ho quindi necessariamente seguito una specifica nomenclatura dei modelli: se una versione di Sonnet superava le capacità del precedente modello Opus, oppure l’evoluzione della linea Flash supera il precedente Pro, ho considerato il nuovo modello posizionato dal vendor stesso come il modello di frontiera del momento.
Come indicatore economico ho adottato il list price standard per milione di token di output, escludendo Batch, Priority e altre modalità particolari e utilizzando, dove previsto, il tier standard della finestra di contesto.
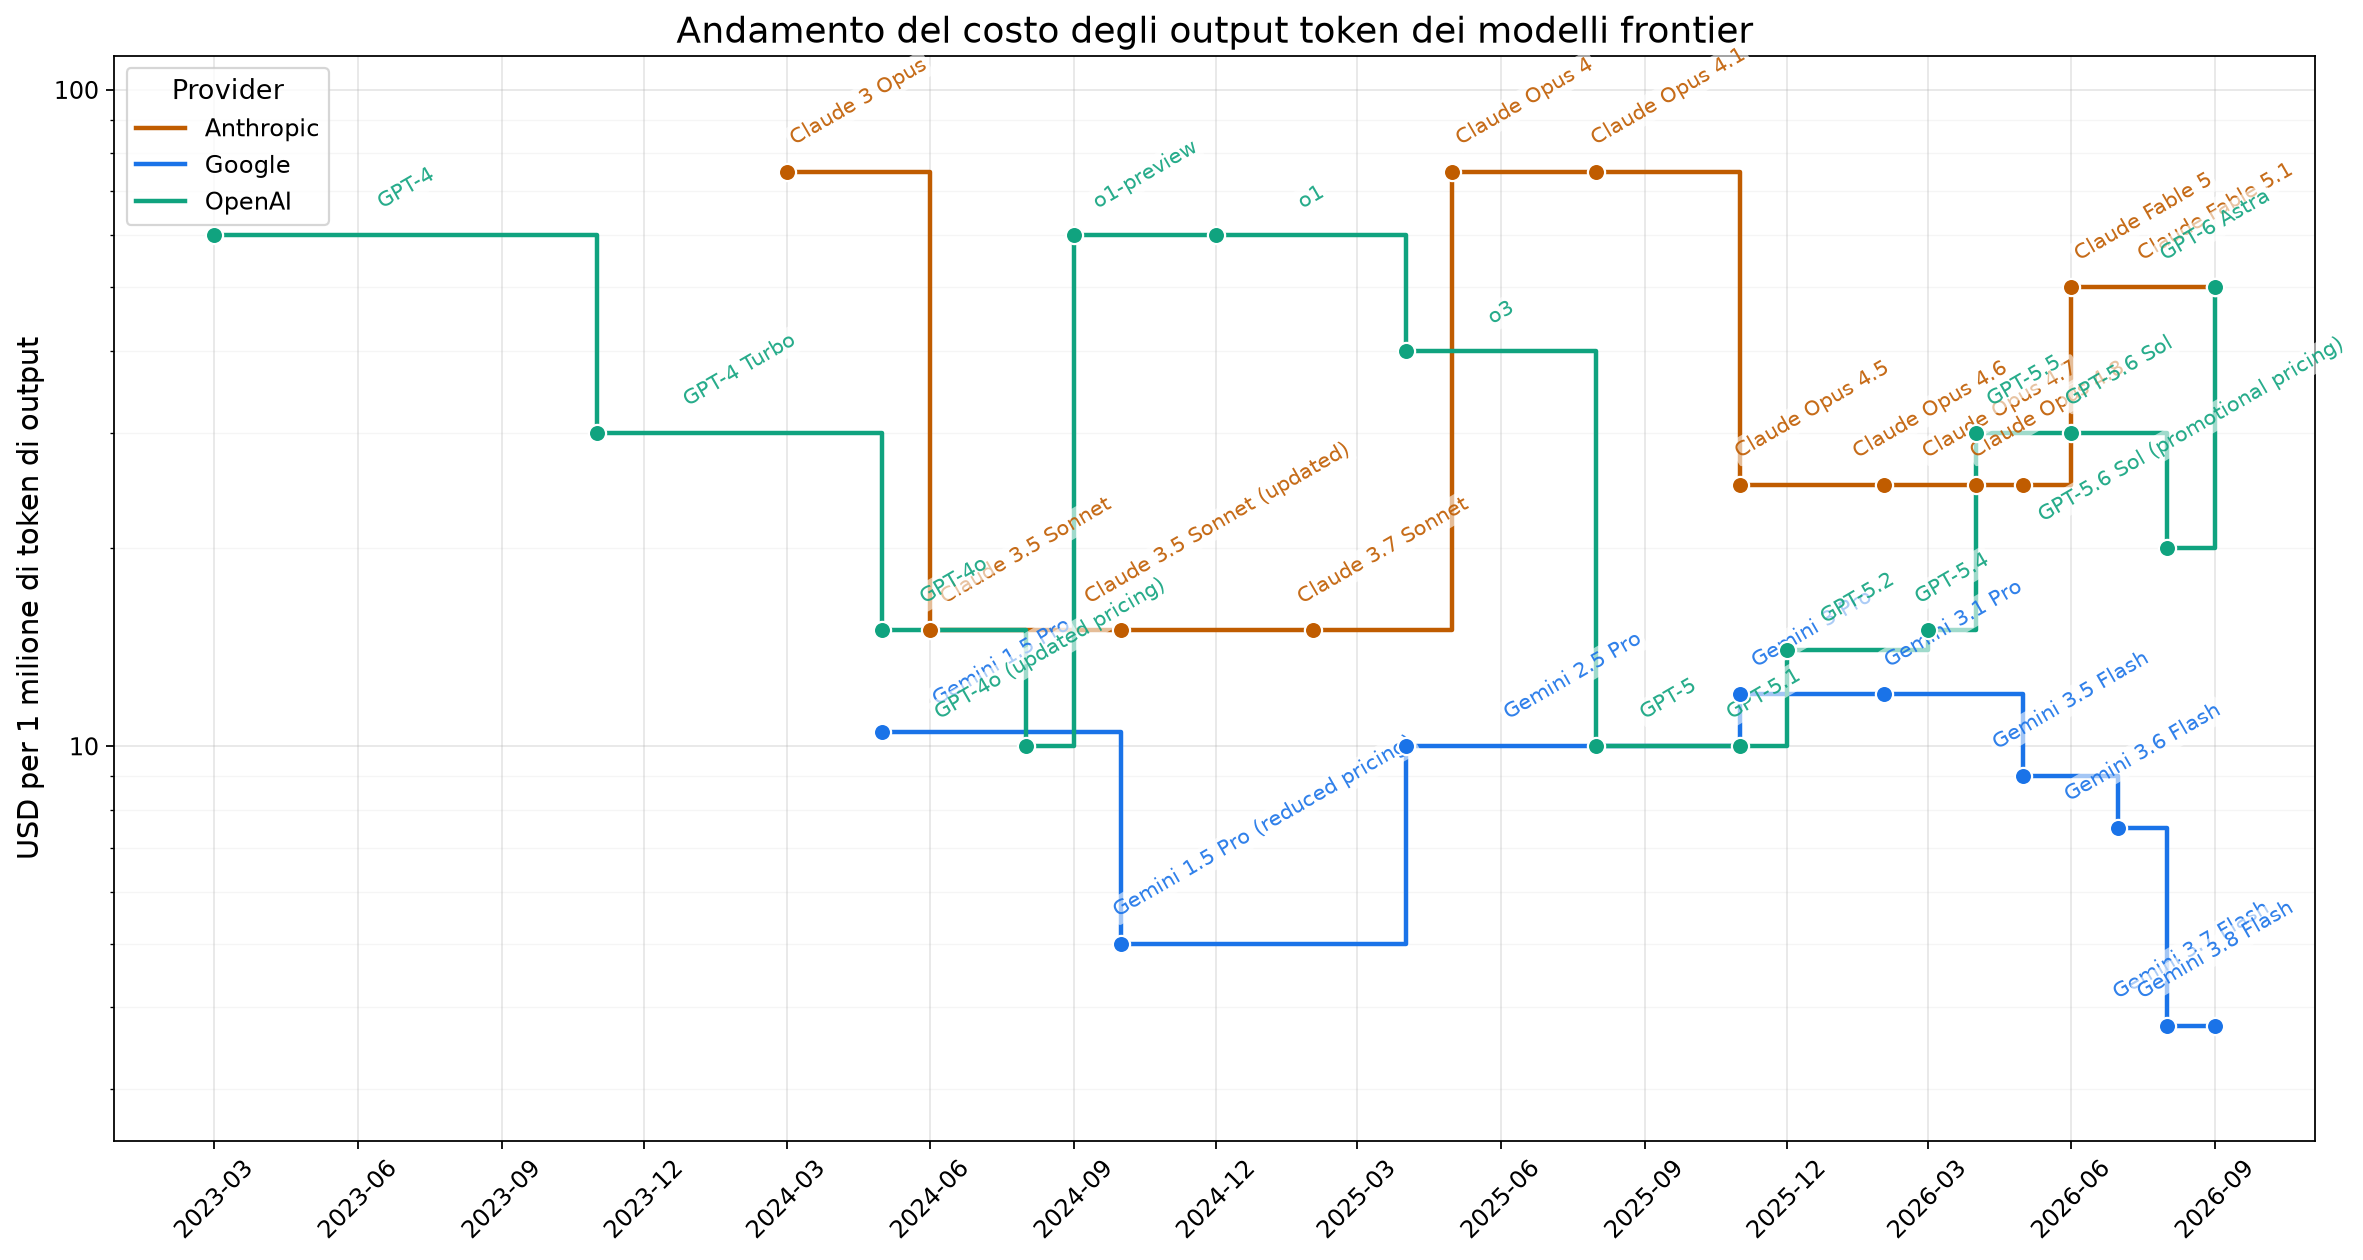
L’asse verticale è in scala logaritmica: ogni tacca corrisponde a un ordine di grandezza nel prezzo per milione di token di output. È un dettaglio importante, perché la scala comprime visivamente distanze che in realtà sono molto grandi. La separazione tra la fascia di OpenAI e Anthropic - che per gran parte del periodo si muovono tra i 15 e i 75 dollari - e quella di Google - che scende fino a pochi dollari - sul grafico sembra contenuta, ma in scala lineare corrisponderebbe a un divario di quasi un intero ordine di grandezza.
Il grafico evidenzia alcune dinamiche interessanti: le curve non si comportano tutte nello stesso modo e non sempre il modello più nuovo costa meno del precedente.
Tre curve, tre strategie
Le tre serie mostrano che la riduzione del costo dei modelli di frontiera non segue una traiettoria unica. OpenAI ha alternato fasi di forte compressione del prezzo a fasi di riposizionamento verso l’alto. Dopo la discesa GPT-4 → GPT-4 Turbo → GPT-4o, l’arrivo dei reasoning model riporta temporaneamente il costo della frontiera su livelli più elevati; con GPT-5 la capacità di reasoning viene progressivamente riassorbita nel flagship general-purpose a prezzi molto più bassi. GPT-5.6 Sol prosegue questa normalizzazione, mentre GPT-6 Astra, a $50/M output, introduce un nuovo riposizionamento premium. La curva OpenAI appare quindi come il risultato di una continua ricerca del punto di equilibrio tra capacità di punta, inference compute e monetizzazione.
Anthropic segue una politica più stabile e segmentata. La frontiera passa da Opus a Sonnet quando quest’ultimo raggiunge prestazioni superiori a un prezzo molto più basso, per poi tornare verso tier premium con Opus 4 e successivamente Fable. La dinamica suggerisce una strategia in cui le riduzioni di costo ottenute da una generazione non vengono necessariamente trasferite in modo permanente al modello di punta: una parte dell’efficienza viene utilizzata per creare nuovi livelli di capacità e mantenere una chiara differenziazione commerciale tra i tier.
La traiettoria di Google è invece nettamente più deflazionistica. La frontiera passa dalla famiglia Pro a Flash mentre le prestazioni continuano a crescere e il prezzo degli output token scende fino a pochi dollari per milione. Il dato è particolarmente significativo perché i benchmark non mostrano un divario di capacità proporzionale al divario di prezzo: Gemini rimane un modello efficace, con costi e throughput molto più favorevoli. Google sembra quindi competere meno sulla monetizzazione dell’ultimo incremento di capacità e più sulla compressione sistematica del costo della capacità frontier, probabilmente favorita dalla scala, dall’integrazione verticale dello stack e dalla possibilità di valorizzare Gemini attraverso un ecosistema di prodotti molto più ampio.
Google gioca una partita diversa
La dinamica dei prezzi di Google merita qualche riflessione aggiuntiva.
Il confronto con benchmark prestazionali indipendenti suggerisce che Google non stia ottenendo quel prezzo molto più basso semplicemente offrendo un modello molto meno capace. Prendendo come riferimento l’Artificial Analysis Intelligence Index, nelle configurazioni a elevato reasoning effort il quadro attuale è approssimativamente questo:
| Modello, effort elevato | AA Intelligence Index v4.2 | Output price | Output speed |
|---|---|---|---|
| Claude Fable 5.1 – max | 57 | $50/M | ~67 tok/s |
| GPT-6 Astra – max | 55 | $50/M | ~73 tok/s |
| Gemini 3.8 Flash – high | 47 | $3.75/M | ~311 tok/s |
Google quindi non è al vertice della classifica e il distacco prestazionale non è trascurabile, ma rimane molto più contenuto rispetto al divario economico. Inoltre ha un throughput (velocità di generazione degli output) significativamente superiore ai diretti concorrenti. È una scelta particolarmente rilevante per workload ad alto volume e sistemi agentici, dove una singola attività può generare decine o centinaia di chiamate al modello.
Dietro i prezzi ci sono strutture economiche diverse
Una possibile spiegazione delle tre curve sta anche nella diversa struttura economica dei provider.
OpenAI e Anthropic sono aziende sostanzialmente AI-native, nelle quali modelli, API e prodotti costruiti sopra i modelli rappresentano il core business dell’azienda. Nel 2026 entrambe hanno anche presentato la documentazione preliminare per una possibile IPO, pur senza definire necessariamente tempi definitivi per la quotazione. È ragionevole aspettarsi una crescente attenzione alla capacità di dimostrare eccellenza tecnologica nei modelli di frontiera sempre più avanzati, efficienza operativa e capacità di monetizzazione.
Obiettivo principale è dimostrare la sostenibilità economica futura dell’enorme investimento in compute. La corsa al modello più avanzato richiede infatti ingenti risorse computazionali che sono oggi nella disponibilità di pochi grandi provider di hardware specializzato (come NVIDIA, AMD e la stessa Google) e datacenter su larga scala (hyperscale).
NVIDIA è stata fondamentale per la crescita di OpenAI, ma l’azienda sta costruendo un portafoglio molto più diversificato che comprende Microsoft, AWS, AMD, Broadcom, CoreWeave, Oracle e altri provider e sta sviluppando propri acceleratori insieme a Broadcom. Anthropic segue a sua volta una strategia multi-hardware: utilizza AWS Trainium, Google TPU e NVIDIA GPU, con AWS come principale cloud e training partner.
I legami fra queste aziende sono così stretti e intricati (tipicamente caratterizzati da partecipazioni incrociate e contratti circolari) da temere che la caduta di uno di questi attori possa avere effetti a catena sull’intero ecosistema facendo scoppiare la cosiddetta bolla della AI (ma questo è argomento per un altro post).
Google parte però da una posizione strutturalmente differente.
Alphabet dispone di fonti di ricavo molto diversificate — Search e advertising, YouTube, Cloud, Workspace, subscription — e Gemini può produrre valore non soltanto attraverso le API, ma aumentando competitività e ricavi dell’intero ecosistema.
Inoltre Google controlla una porzione più ampia dello stack tecnologico. Accanto alle GPU NVIDIA, progetta da dieci anni le proprie TPU, oggi utilizzate per il training e il serving di Gemini su larga scala. Alphabet dichiara che nel solo 2025 le ottimizzazioni di modello, infrastruttura e utilizzo hanno ridotto del 78% il costo unitario di serving di Gemini.
È quindi plausibile — non dimostrabile dal solo listino — che il pricing aggressivo di Gemini rifletta la combinazione di integrazione verticale, economie di scala e possibilità di monetizzare l’AI indirettamente attraverso altri business.
Google può avere, in altre parole, una strategia e una funzione obiettivo diversa da quella di un pure player dei foundation model. Anche la complessa struttura del gruppo Alphabet può mettere in atto strategie diversificate che investono in filoni di ricerca alternativi (es. i world model sperimentati da DeepMind) senza puntare all’eccellenza di un unico modello e senza compromettere la trasformazione agentica del proprio core business.
Domanda più veloce dell’offerta
Quando le tecnologie maturano e si diffondono su larga scala diventano più efficienti, il loro costo unitario tende a scendere e le soluzioni più avanzate producono risultati migliori a parità di costo.
Questo sta avvenendo anche nel caso dell’AI generativa (capacità che pochi anni fa erano disponibili soltanto nei modelli più costosi vengono progressivamente offerte da modelli molto più economici), ma non per i modelli di frontiera la cui realizzazione richiede ingenti risorse computazionali su larga scala. Uno dei temi da non trascurare per il prossimo futuro è costituito dall’equilibrio tra domanda e capacità di offerta.
La domanda sta effettivamente crescendo e le sempre migliori abilità dei modelli ampliano gli ambiti di utilizzo effettivo e conseguentemente la domanda. Probabilmente però siamo solo agli inizi di una crescita esponenziale di questa curva di domanda: ad oggi la capacità delle aziende di introdurre tali tecnologie in modo pervasivo nei propri processi operativi e decisionali è ancora limitata. Sono presenti molti ostacoli per una adozione diffusa (anche questo è un valido argomento per altro post), ma è ragionevole pensare che - con l’accelerazione del processo di trasformazione dei grandi player sotto la pressione dei nuovi outsider - presto la curva di domanda potrebbe impennarsi.
Sull’altro fronte esistono limiti tecnologici, vincoli infrastrutturali e costi operativi che impediscono alla capacità di offerta di crescere altrettanto rapidamente quanto la domanda. Il primo fra tutti è la disponibilità di hardware specializzato, come GPU, TPU e RAM, necessarie per il training e il serving dei modelli su larga scala. A questo si aggiungono pariteticamente i costi energetici e gli impatti ambientali legati alla creazione di nuovi datacenter. Operazione che di per sé richiede tempi tecnici di realizzazione, investimenti significativi e pianificazione a lungo termine. Inoltre la costruzione di nuovi datacenter sempre più spesso sta incontrando resistenze locali, normative più stringenti e difficoltà nell’ottenere le autorizzazioni necessarie. Questi fattori contribuiscono a mantenere la capacità di offerta relativamente rigida nel breve periodo.
Questo potenziale squilibrio tra una domanda che potrebbe crescere velocemente e un’offerta che fatica a tenere il passo può contribuire ad un aumento dei prezzi unitari dei modelli di frontiera. Aumento che sarebbe difficile da riassorbire nel breve termine, soprattutto per aziende AI-native come OpenAI e Anthropic, in cui gli enormi investimenti necessari per ampliare capacità computazionale e infrastruttura devono progressivamente tradursi in crescita dei ricavi e margini sostenibili, esigenza destinata a diventare ancora più visibile con l’eventuale quotazione in borsa.
Il prezzo del token non è il costo del risultato
Il prezzo per token rimane un indicatore utile per osservare le politiche commerciali dei provider, ma non coincide con il costo reale di un task o di una soluzione.
Un modello più costoso può risultare economicamente preferibile se raggiunge il risultato con meno iterazioni, meno verifiche e minore intervento umano; al contrario, un modello molto più economico può essere imbattibile su workload semplici, ripetitivi o fortemente parallelizzabili. Con reasoning e sistemi agentici il confronto diventa ancora più complesso, perché il consumo dipende anche da pianificazione, tool use, retry, retrieval, caching, verifiche automatiche e cicli intermedi. Il parametro economicamente più significativo sarebbe quindi il costo per task completato con il livello di qualità richiesto. Tecniche di harnessing più sofisticate possono inoltre aumentare l’efficacia dei modelli più economici e ridurne il gap rispetto a quelli frontier. Per questo il prezzo per milione di token è una componente necessaria dell’analisi economica, ma va sempre inserita in una valutazione più ampia del costo complessivo e della qualità del risultato.
Per chi costruisce prodotti o sperimenta innovazione, la domanda giusta non è quale modello costi meno per milione di token. La domanda più utile diventa quale combinazione di modello, architettura e processo produce il risultato desiderato al costo complessivo più prevedibile.